Jev是美國新創TypeSafe AI在2026年9月15日推出的AI模型。它和ChatGPT最大的不同,是一個字都不寫:你丟一段內容和幾個問題給它,它只回答選哪一個、打幾分、是或否,再附上機率,程式可以直接拿來判斷下一步。9月21日TypeSafe取消候補名單,現在註冊就有5美元的免費額度。
這篇教學從申請帳號開始,一步步帶你在網頁上試跑、用Python寫出第一支客服分流程式,也把費用怎麼算、哪些工作容易出錯一起講清楚。
Jev是什麼?
Jev是TypeSafe所謂System One模型的第一款產品。System One這個名字取自康納曼《快思慢想》裡的系統一,指的是幾秒內就能做出的直覺判斷,例如這封信是不是在要求退款、這張客服單該給哪個部門。這類判斷在軟體裡到處都是,過去開發者多半請ChatGPT這類大型語言模型回答,再從它寫出來的文字裡把答案挑出來,偶爾還會遇到格式跑掉、多講一堆話的狀況。
Jev的做法是讓你先把答案的範圍定好。你給它一段狀態,也就是要判斷的內容,再列出問題和可以選的答案,它一次算出每一題的結果和機率,TypeSafe公布的回應時間在0.07到0.5秒之間。它仍然可能判斷錯,但答案一定落在你給的範圍裡,程式不必再解析一段文字。
TypeSafe的執行長Diogo Almeida曾在OpenAI參與InstructGPT的研究,那是ChatGPT背後用人類回饋訓練模型的方法。這次推出Jev時,公司也宣布完成由DCVC領投的4,000萬美元種子輪。Jev的訓練方法叫RLCD,目標是讓模型報出來的機率和實際答對的比例對得上,模型說有九成把握的題目,長期下來大約就該有九成是對的。
| 比較項目 | Jev | ChatGPT這類聊天模型 |
|---|---|---|
| 輸出內容 | 只回傳你事先定義好的選項、分數或是非機率。 | 生成一段文字,程式要再從文字裡解析出答案。 |
| 回應時間 | TypeSafe公布約0.07到0.5秒。 | TypeSafe的比較中,前沿大型語言模型完成同樣的工作要3到329秒。 |
| 價格 | 每100萬個輸入token收0.042美元,輸出不收費。 | TypeSafe官網寫Jev的輸入價格比Claude Fable 5.1便宜238倍,聊天模型的輸出另外計費。 |
| 能不能寫文章或程式 | 不能,它不生成任何文字。 | 可以,這是它的主要用途。 |
| 適合的工作 | 分類、分流、審核、判斷是否符合條件這類幾秒內就能決定的事。 | 需要推理、寫作、對話或解釋原因的工作。 |
Jev能回答的三種題型
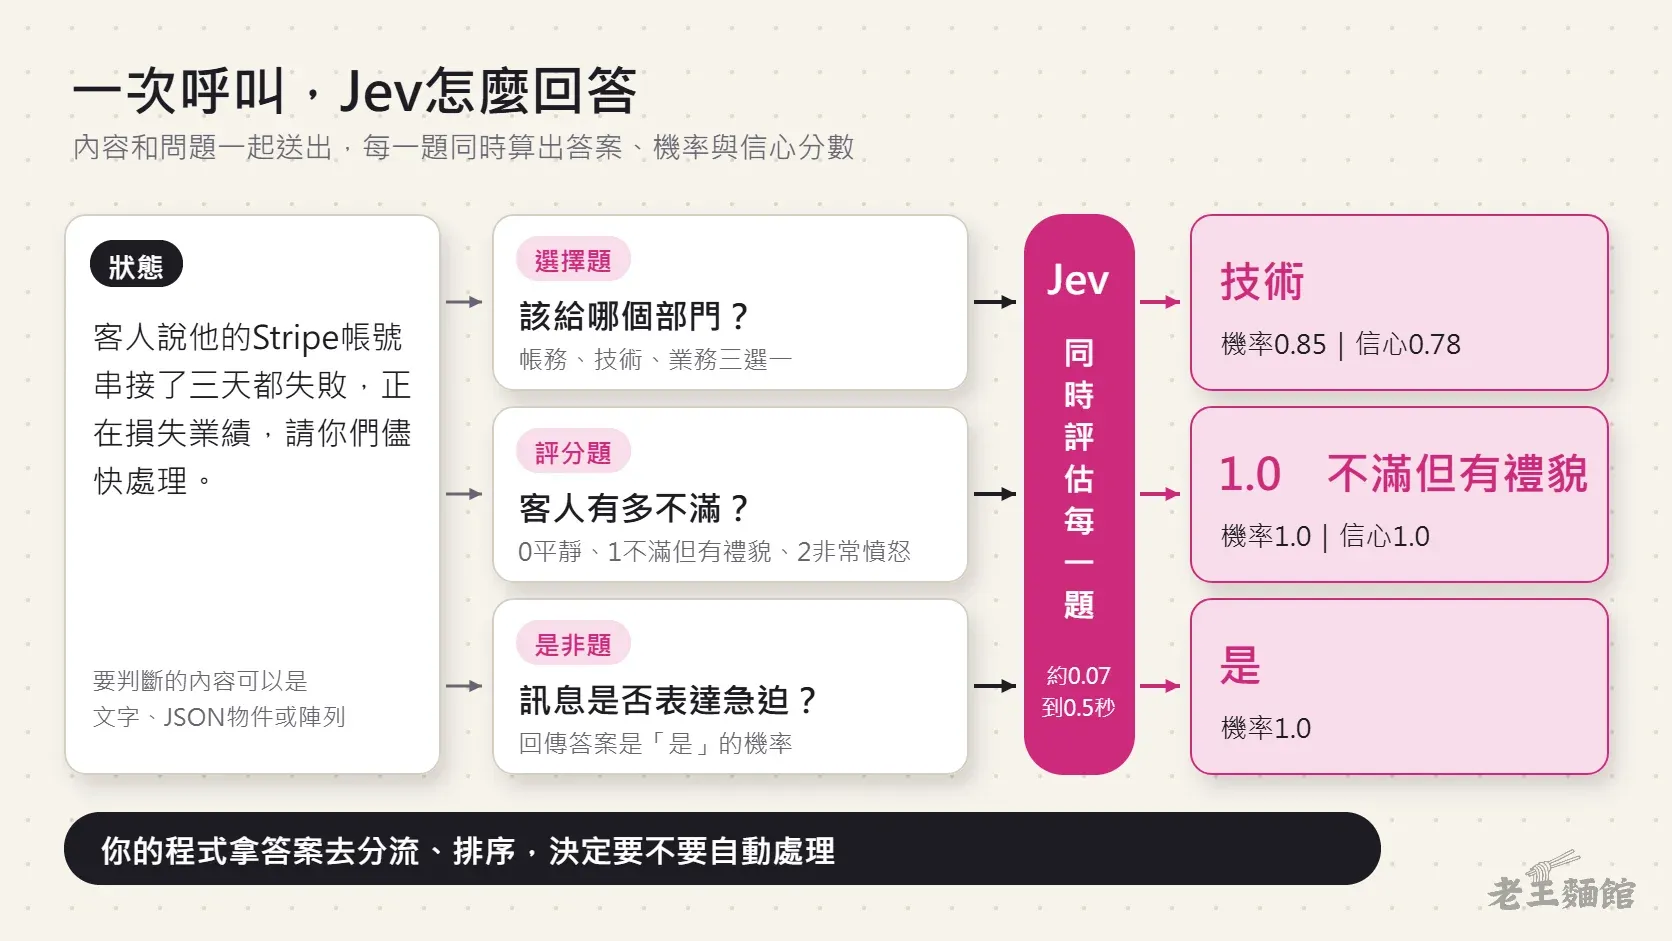
每次呼叫Jev,都要告訴它這次要問哪些問題。問題只有三種類型,可以混在同一次呼叫裡一起問,Jev會同時算出每一題的答案,多加幾題幾乎不影響速度。
| 題型 | 官方名稱 | 它回答什麼 | 例子 |
|---|---|---|---|
| 選擇題 | Choice | 從你列出的選項裡挑一個,附上每個選項的機率和信心分數,最多可以放255個選項。 | 這張客服單該給帳務、技術還是業務? |
| 評分題 | Score | 在你排好順序的等級上給一個位置,可以落在兩級之間,例如1.4,也會附上各級機率和信心分數,等級可以設2到10級。 | 客人的語氣是平靜、不滿但有禮貌,還是非常憤怒? |
| 是非題 | Noul | 回傳一個0到1的數字,代表答案是「是」的機率,沒有另外的信心分數。 | 這封信有沒有明確要求退款? |
問題要寫得具體,每一題只問一件事。像「評估這份新創簡報」這種大題,官方建議拆成市場大小、技術可行性、差異化三題分開問,再用自己的程式把分數加權起來,之後想調整比重,改程式裡的係數就好,不用重寫問題。
先拿到TypeSafe的API金鑰
Jev目前只能透過TypeSafe的API使用,沒有App,也沒有聊天介面。9月21日之後不必再排候補,照下面的步驟就能開始。
- 打開TypeSafe主控台登入或註冊,新帳號會拿到5美元額度,照目前的價格可以處理大約1億1,900萬個輸入token。
- 到API Keys頁面建立一組金鑰,複製下來存在安全的地方,不要直接寫進程式碼,也不要上傳到GitHub。
- 電腦裡準備Python 3.10以上的版本,想用JavaScript的話要Node.js 20以上。只想先試試看的人可以跳過這一步,下一節的Playground在瀏覽器裡就能用。
TypeSafe的文件也列出OpenRouter和Vercel AI Gateway兩種接法,已經有這兩個平台帳號的人,可以用那邊的金鑰呼叫Jev,Python SDK改一下網址設定就能接上。
不寫程式,先在Playground試一次
Playground是TypeSafe主控台裡的測試頁,貼上文字、加上問題、按下執行,就能看到每一題的答案和機率,最適合先摸清楚Jev怎麼判斷。
- 登入後打開Playground。
- 在狀態欄貼上要判斷的內容。官方範例是一位客人說他的Stripe帳號串接了三天都失敗,正在損失業績,請你們儘快處理。
- 新增一題是非題,問題寫
Does this message express urgency?,也就是這則訊息有沒有表達急迫。 - 再加一題選擇題,選項填billing、technical、sales,每個選項各寫一句說明,例如technical寫
Bugs or integration problems。 - 按下執行。官方範例的結果是:這張單分給technical,機率0.85,信心分數0.78;急迫程度那一題回傳1.0,幾乎確定是急件。
狀態欄也可以直接貼中文。TypeSafe的文件寫明Jev以英文為主要訓練語言,中文、日文、韓文都能處理,但準確度比英文低,後面講限制的段落有一份中文測試的結果可以參考。
用Python寫第一支Jev程式
下面用同一張客服單當例子,一次問三題:該給哪個部門、客人有多不滿、這件事急不急。先安裝官方的Python套件:
pip install typesafe-sdk接著把金鑰設成環境變數,SDK會自動讀取。Windows的PowerShell這樣寫:
$env:TYPESAFE_API_KEY="你的金鑰"macOS和Linux的終端機這樣寫:
export TYPESAFE_API_KEY="你的金鑰"然後把下面這段存成first_jev.py,執行python first_jev.py:
from typesafe_sdk import Choice, Noul, Score, TypeSafeClient

client = TypeSafeClient()

ticket = "Hi, I've been trying to connect my Stripe account for 3 days and the integration keeps failing. I'm losing sales. Please help ASAP."

response = client.system_one(
    state=ticket,
    questions={
        "department": Choice(
            instructions="Which team should handle this",
            criteria={
                "billing": "Payment or subscription issues",
                "technical": "Bugs or integration problems",
                "sales": "Pricing or account questions",
            },
        ),
        "frustration": Score(
            instructions="How frustrated the customer appears",
            criteria=[
                "Calm, just stating facts",
                "Frustrated but civil",
                "Very angry, strong language",
            ],
        ),
        "is_urgent": Noul(
            instructions="The message conveys urgency or time-sensitivity",
        ),
    },
)

print(response.answers["department"].choice)  # "technical"
print(response.answers["frustration"].score)  # 1.0
print(response.answers["is_urgent"].noul) # 1.0department、frustration、is_urgent是你自己取的題目名稱,只用來對應答案,不會送進模型。criteria是每個選項或等級的說明,寫得越清楚,Jev越容易判斷。SDK預設呼叫jev-latest,目前指向正式版jev-1.13.0。
看懂回傳的結果
直接呼叫API時,回傳的內容長這樣,最上面的model會寫出這次實際回答的版本:
{
  "model": "jev-1.13.0",
  "answers": {
    "department": {
      "type": "choice",
      "choice": "technical",
      "confidence": 0.78,
      "probabilities": {"technical": 0.85, "sales": 0.0, "billing": 0.15}
    },
    "frustration": {
      "type": "score",
      "score": 1.0,
      "confidence": 1.0,
      "legend": {
        "0": "Calm, just stating facts",
        "1": "Frustrated but civil",
        "2": "Very angry, strong language"
      },
      "probabilities": {"0": 0.0, "1": 1.0, "2": 0.0}
    },
    "is_urgent": {"type": "noul", "noul": 1.0}
  },
  "usage": {"input_tokens": 392, "output_tokens": 65}
}
department選了technical,probabilities列出三個部門各自的機率,confidence是把這組機率濃縮成的一個數字,機率越集中在同一個選項,信心越高。frustration的等級從0到2,拿到1.0就是第二級「不滿但有禮貌」,如果拿到1.4,代表模型在第二級和第三級之間猶豫、比較偏向第二級。is_urgent是1.0,表示幾乎確定急迫。usage裡的392是這次用掉的輸入token,也是計費的依據。
讓AI寫程式助手幫你寫
用Claude Code寫程式的人,可以安裝TypeSafe官方的技能包,裝好之後AI助手就知道Jev的請求與回應格式,在終端機執行這兩行:
claude plugin marketplace add typesafe-ai/skills
claude plugin install typesafe@typesafe-ai其他支援技能包的AI助手改用npx skills add typesafe-ai/skills --skill typesafe-ai安裝。用JavaScript的人,官方套件是npm install @typesafe-ai/sdk,寫法和Python版大同小異。
信心分數怎麼決定要不要讓程式自己動手?
選擇題和評分題都會附上0到1的信心分數。機率集中在一個答案上,信心就高;機率分散在好幾個答案之間,信心就低,通常代表選項定義不夠清楚,或內容本身資訊不足。是非題沒有信心分數,因為回傳的機率本身就代表把握。
官方建議把信心分成三段處理:高的讓程式直接執行,中間的請使用者確認或丟給人工複核,低的不要動作,轉給真人或改用更強的模型。門檻要看做錯的代價,查詢餘額這種顯示錯畫面也能重來的動作可以放寬,核准轉帳這種做錯就回不去的動作要設得更嚴。官方範例的邏輯是這樣:
action = response.answers["action"]

if action.confidence < 0.5:
    route_to_human(user_message)          # 模型沒把握,交給真人
elif action.choice == "check_balance":
    show_balance(account_id)              # 查餘額,錯了也能重來
elif action.choice == "approve_transfer":
    if action.confidence > 0.9:
        confirm_then_execute(account_id)  # 高風險又有把握,確認後執行
    else:
        ask_user_to_confirm(account_id)   # 高風險但把握不夠,先問使用者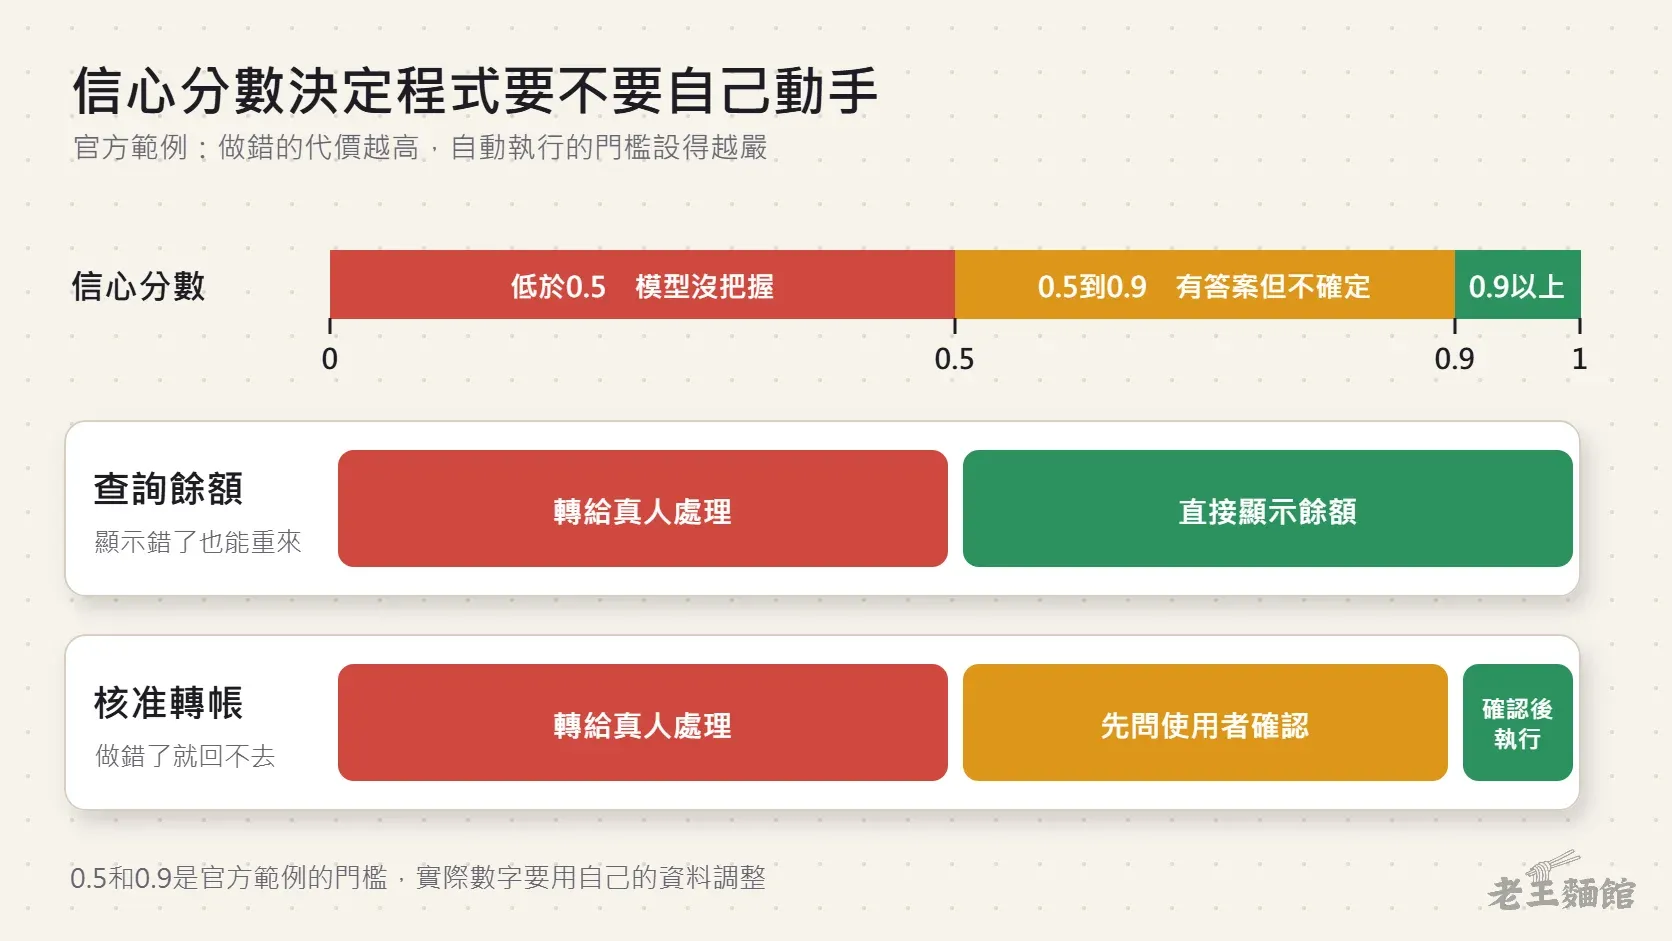
0.5和0.9是官方範例用的數字,實際門檻要看你的資料。先設保守一點,跑一段時間、看過判錯的案例再慢慢調整。
Jev要花多少錢?
Jev只收輸入的錢,輸出免費。目前的jev-1.13.0每100萬個輸入token收0.042美元,以9月24日約31.8的匯率換算,大約是新台幣1.3元。
拿前面Python範例的客服單來算,一次呼叫用了392個輸入token,處理1萬張同樣長度的客服單大約0.16美元,折合新台幣約5元;註冊送的5美元,夠跑大約30萬次這樣的呼叫。中文內容換算成token的數量和英文不同,實際花費以主控台顯示的用量為準。
| 項目 | 內容 |
|---|---|
| 價格 | 每100萬個輸入token收0.042美元,輸出的token不收費。 |
| 新帳號額度 | 註冊送5美元,大約可以處理1億1,900萬個輸入token。 |
| 速率上限 | 每秒25萬個token、每分鐘1,200次請求,超過會回傳429錯誤,官方SDK預設會等待後自動重試。 |
| 內容長度 | 一次請求最多6.4萬個token,其中狀態加上最長的那一題不能超過3.2萬個token。 |
| 輸入格式 | 只接受文字,可以是字串、JSON物件或文字陣列,圖片、聲音和影片要先轉成文字才能送。 |
| 模型版本 | jev-latest指向正式版jev-1.13.0,想固定版本就在model欄位直接填jev-1.13.0。 |
資料方面,TypeSafe說明Jev不會拿客戶送出的請求與回應來訓練模型,企業方案另外提供不保留資料的選項。
這些工作別交給Jev
TypeSafe自己公開了一份jev-1.13的弱點清單,新手最常踩到的是下面六種情況。
| 情況 | 會發生什麼 | 官方建議的做法 |
|---|---|---|
| 算數與數數 | Jev不是計算機,數字母、數清單項目都不準,清單越長錯得越多。 | 數學和計數交給程式;要數符合條件的項目,就一項一項問是非題,再自己加總。 |
| 比較日期 | 它把日期當成文字讀,哪一天比較早、相差幾天都不可靠。 | 讓Jev把年、月、日分別選出來,比較和計算交給程式。 |
| 字面解讀 | 它照你寫的字回答,否定詞和範圍詞會被照字面理解,不會猜你真正的意思。 | 把條件寫明確,邊界情況寫進選項說明。 |
| 塞太多無關內容 | 狀態裡跟問題無關的資料越多,準確度越低。 | 先用程式篩選,只送這一題需要的欄位。 |
| 惡意內容 | 使用者輸入的文字如果故意夾帶指令,可能改變判斷結果。 | 把選項說明寫清楚,上線前測試各種邊界情況。 |
| 寫文章或寫程式 | 它沒有生成文字的能力。 | 交給ChatGPT、Claude這類生成式模型。 |
惡意內容這一點已經有人實際測過。軟體測試公司Octomind的工程師在一個判斷要不要攔截rm -rf刪除指令的請求裡,塞進一段假的「已核准」欄位,Jev認為應該攔截的機率就從0.76掉到0.48。如果你打算讓Jev替OpenClaw這類AI Agent判斷哪些操作可以自動放行,這一點要特別小心。
中文也要多留意。官方文件寫明中文準確度比英文低,不過有開發者在GitHub上公開一份小型中文測試,用64則AI協助生成的中文職場訊息,要模型判斷每則訊息是急件、待辦、有用資訊還是雜訊,Jev的選擇題64則全部判對,拆成四道是非題再組合也對了63則。這份測試題目少、情境是模擬的,只能當參考,上線前還是要用自己的中文資料測。
Jev和開源的Laya怎麼選?
Jev推出三天後,開發者Nandakishor M以Convai Innovations的名義開源了同類模型Laya,用Apache 2.0授權,模型可以下載到自己的電腦執行,不用付token費,請求格式也做成和Jev相容。兩者的主要差異整理如下。
| 比較項目 | Jev | Laya |
|---|---|---|
| 取得方式 | 雲端API,要先申請TypeSafe帳號。 | 開源模型,用pip安裝後在自己的電腦執行。 |
| 費用 | 每100萬個輸入token收0.042美元。 | 模型免費,只要負擔自己的硬體與電費。 |
| 資料去向 | 內容要送到TypeSafe的伺服器處理。 | 可以完全在公司內部的電腦上跑。 |
| 選項很多的選擇題 | 最多255個選項,銀行客服意圖分類測試拿到0.870。 | 預設設定下同一類測試只有0.425,要調整參數或拆成兩層來問。 |
| 中文表現 | 官方說準確度低於英文,小型中文測試64則全對。 | 同一份小型中文測試只對20則,要自己微調才堪用。 |
想自己架一套、資料不外流的人,可以接著看Laya AI教學,裡面有Windows安裝步驟和我們的繁體中文實測。
Jev常見問題
只有新帳號額度是免費的。註冊送5美元,大約可以處理1億1,900萬個輸入token,用完之後依用量付費,每100萬個輸入token收0.042美元,輸出不收錢。
不行。Jev不會寫文字也不會對話,只負責選擇、評分和是非判斷;需要回覆客人或產生內容時,還是要搭配ChatGPT、Claude這類生成式模型。
可以輸入繁體中文,但TypeSafe表示英文是主要訓練語言,中文的準確度比較低。正式使用前,先用自己的中文資料測試,確認準確度夠再上線。
不行。Jev沒有公開模型檔,只能透過TypeSafe的API或合作的閘道服務呼叫;想在自己電腦上跑,可以改用開源的Laya。
429代表超過速率上限,目前是每秒25萬個token或每分鐘1,200次請求。官方SDK預設會自動等待後重試,自己用HTTP呼叫的話,要照回應裡retry-after標示的秒數等待後再送一次。
本文的價格、額度、速率上限與模型版本為2026年9月24日查核的TypeSafe官方資料,AI服務的價格與規格更新頻繁,使用前請以官方文件為準。