Laya是Convai Innovations在2026年9月18日開源的AI決策模型,用途和TypeSafe的Jev一樣:丟一段內容和幾個問題給它,它回答選哪一個、打幾分、是或否,附上機率,一個字都不生成。差別在Laya用Apache 2.0授權公開模型,可以免費下載到自己的電腦執行,不用申請帳號,也不用付token費,上線不到一週,GitHub專案就累積超過2萬顆星。
下面從不用安裝的線上試用開始,再到Windows安裝、寫第一支程式、架成自己的API,中間也放了我們用繁體中文實際測試的結果,決定要不要投入之前可以先看。
Laya從哪裡來?
Laya的作者是Nandakishor M,以Convai Innovations的名義發布。他在自己的文章裡提到,2025年就發表過兩篇非自回歸決策模型的論文,TypeSafe推出Jev之後,他把這套做法整理成Laya,在Hugging Face、GitHub和PyPI同步上線,請求格式也刻意做成和Jev相容。
非自回歸的意思是它不像ChatGPT那樣一個字接一個字往下寫,整段內容和所有問題只跑一次模型就算出答案,所以很快。官方在Tesla T4顯示卡上量到,問一題的回應時間約33到40毫秒。
訓練方法同樣叫RLCD,用強化學習獎勵誠實的機率:模型說有八成把握,長期下來就該有八成答對,虛報把握會被扣分。作者說訓練資料全部來自人工標註的公開資料集,沒有使用AI生成的標籤。
三個模型版本與自動分流
| 版本 | 底層模型 | 參數量 | 一次能讀的長度 | 適合的內容 |
|---|---|---|---|---|
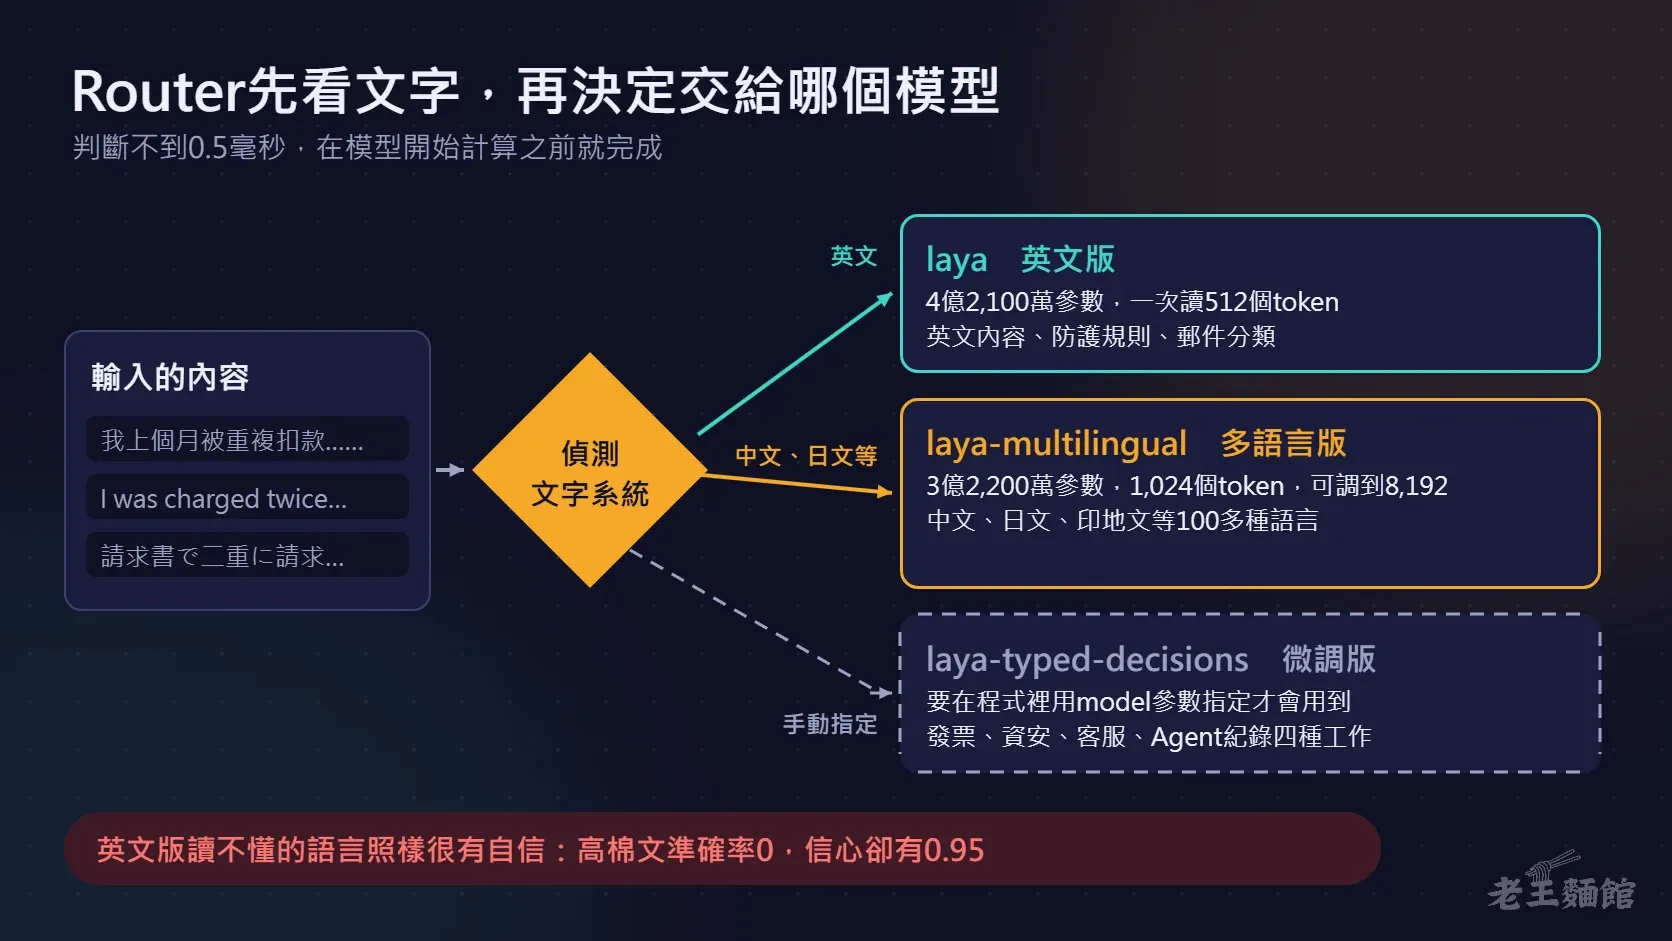
| laya | ModernBERT-large | 4億2,100萬 | 512個token | 英文內容,例如提示詞防護、郵件分類、客服分流。 |
| laya-multilingual | mmBERT-base | 3億2,200萬 | 1,024個token,最多可以調到8,192個 | 中文在內的100多種語言,速度比英文版快約一倍。 |
| laya-typed-decisions | ModernBERT-large | 4億2,100萬 | 1,024個token | 發票處理、資安事件、客服、AI Agent執行紀錄這四種工作,是微調過的版本。 |
新手不用自己挑。Laya內建的Router會在跑模型之前先看文字用的是哪種文字系統,英文交給laya,中文、日文、印地文這類非拉丁字母交給多語言版,這個判斷不到0.5毫秒就完成。要先分流是因為英文版遇到讀不懂的語言時不會顯得沒把握,官方測試英文版處理高棉文,準確率是0,信心分數卻高達0.95。
第一次使用某個版本時,程式會自動從Hugging Face下載模型,英文版約808MB,多語言版約647MB,之後就存在電腦裡重複使用。
不安裝,先在Hugging Face試用
官方在Hugging Face架了一個試用頁,打開瀏覽器就能玩,適合先看看Laya回傳的東西長什麼樣子。
- 打開Laya試用頁,上方有客服分流、郵件與釣魚信、LLM防護、RAG段落過濾、內容審核、模型分流、多語言分流和自由測試幾個分頁。
- 點Support triage,在customer message欄位貼一段客人的訊息,下方還能選客戶等級,並拉動自動處理需要的信心門檻。
- 按Ask,表格會列出每一題的答案和信心分數,表格下面一行是依門檻算出來的處理方式,例如轉給帳務部門並請主管核准。
- 點開raw response,可以看到完整的回傳內容,也就是之後寫程式時會拿到的資料。
客服分流這類分頁用的是英文版模型,要測中文請切到Multilingual routing分頁,它會先分流再回答。貼進試用頁的內容會送到Hugging Face的伺服器處理,客戶資料這類機密不要拿來測。
我們用繁體中文實測的結果
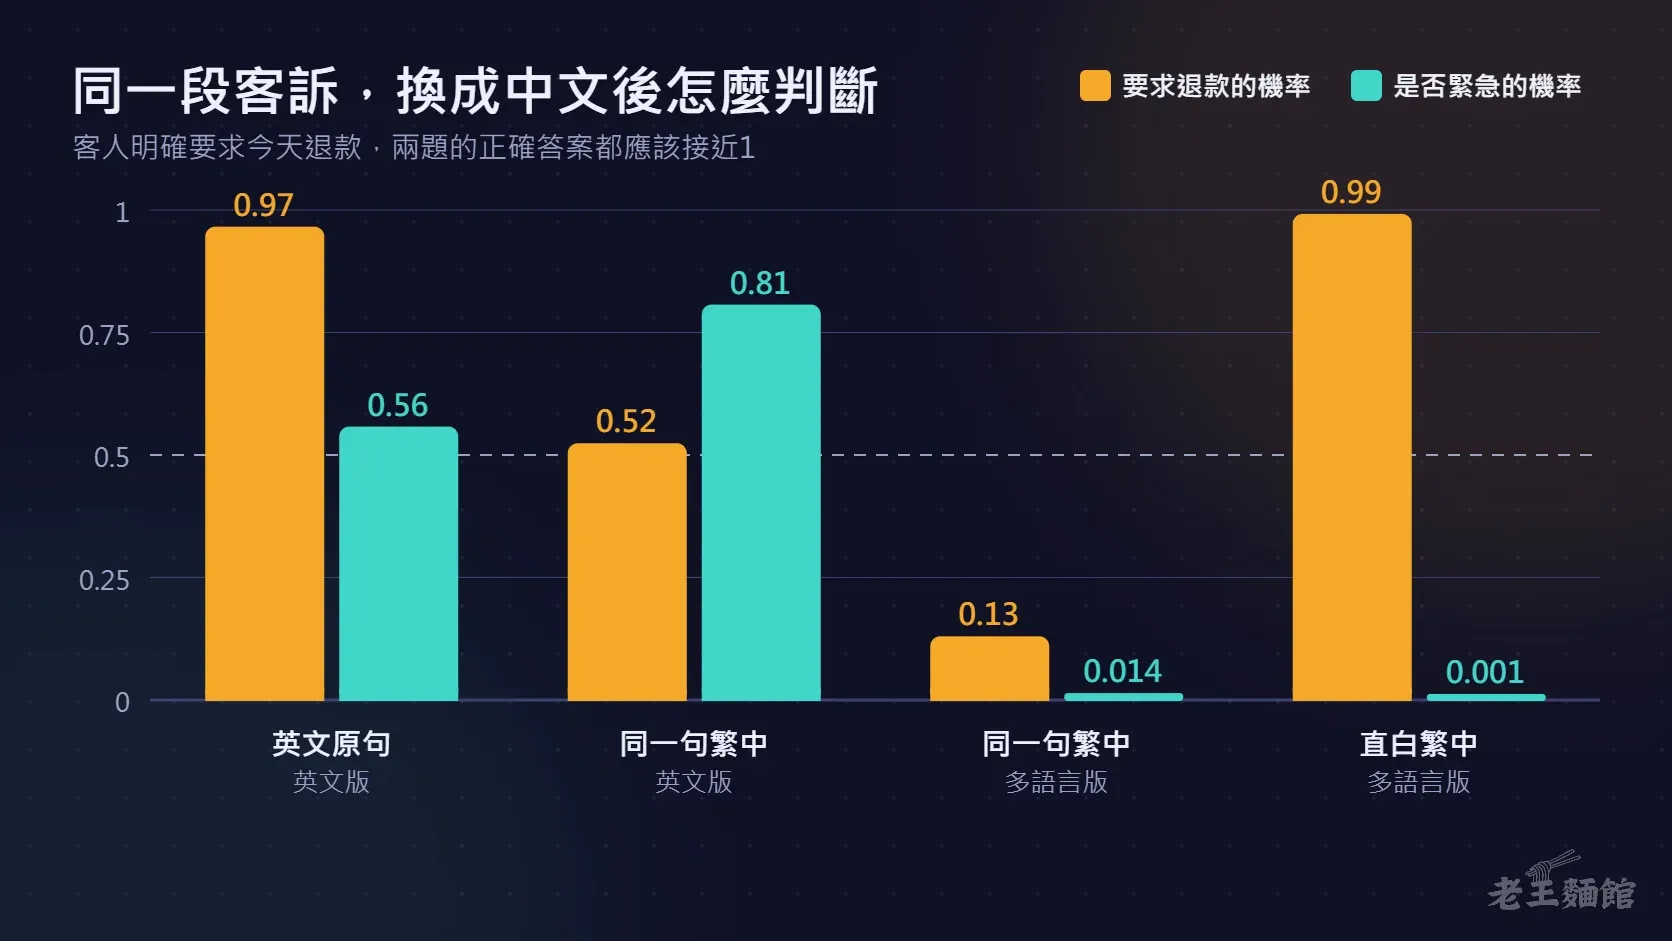
9月24日我們在試用頁用同一段客訴測了幾次,中文原句是「我上個月的訂閱被重複扣款兩次,寄信給客服三天都沒人回。今天再不退款,我就要取消會員。」另外準備意思相同的英文版當對照,最後再換一句比較直白的中文。這段訊息明確要求退款,也要求今天處理,兩題的正確答案都應該接近1。
| 測試內容 | 使用的模型 | 要求退款的機率 | 是否緊急的機率 | 結果 |
|---|---|---|---|---|
| 英文原句 | 英文版laya | 0.97 | 0.56 | 意圖判為退款,信心0.90,判斷正確,但急迫程度只在中間。 |
| 同一句繁體中文 | 英文版laya | 0.52 | 0.81 | 意圖還是判為退款,但退款0.56、取消會員0.39,信心掉到0.50。 |
| 同一句繁體中文 | 多語言版 | 0.13 | 0.014 | 部門正確判為帳務,卻認定客人沒有要求退款,也不急,而且信心很高。 |
| 「發票4411被重複扣款,三天沒有人回覆。請今天退款。」 | 多語言版 | 0.99 | 0.001 | 直白寫出請退款就判對了,急迫程度仍然判錯。 |
英文版也不是全對,英文原句明講要取消會員,流失風險那一題只給了0.375。兩個分頁內建的問題寫法不完全相同,幾句話的測試也不能代表整體準確率,但方向和社群的測試一致:有開發者在Laya的GitHub上公開一份小型中文測試,用64則AI協助生成的中文職場訊息判斷急件、待辦、有用資訊或雜訊,多語言版在選擇題只對了20則,同一批題目Jev對了64則。
要拿Laya處理中文,比較實際的做法是準備自己的中文標註資料做微調,後面會講到怎麼做,或是先讓它只負責英文內容。
在Windows安裝Laya
Laya需要Python 3.10以上。沒有獨立顯示卡也能跑,官方在CPU上量到每次約0.19到0.46秒;有NVIDIA顯示卡時約0.03秒。想用顯示卡加速,要先照PyTorch官網選好對應CUDA版本的安裝指令,裝完PyTorch再裝Laya。
- 安裝Python 3.10以上的版本,官方範例用的是3.11。
- 打開PowerShell,切換到要放專案的資料夾,建立一個虛擬環境。
- 用虛擬環境裡的Python安裝Laya。
- 印出版本號確認安裝成功,看到0.3.20這類數字就完成了。
第二到第四步的指令依序是:
py -3.11 -m venv .venv
.\.venv\Scripts\python.exe -m pip install laya
.\.venv\Scripts\python.exe -I -c "import laya; print(laya.__version__)"
每一行都直接指定虛擬環境裡的python.exe,這樣安裝和執行一定用到同一個環境,不會發生套件裝進一個Python、程式卻用另一個Python執行的狀況。
macOS與Linux的指令
Debian和Ubuntu如果建立虛擬環境時說缺少ensurepip,先執行sudo apt install python3-venv再重試。
python3 -m venv .venv
.venv/bin/python -m pip install laya
.venv/bin/python -I -c "import laya; print(laya.__version__)"
安裝後常見的三個錯誤
- 出現
No module named 'laya':安裝和執行用的不是同一個Python,程式也要用.venv裡的python執行,VS Code這類編輯器要選同一個直譯器。 - 載入模型時卡住不動:電腦裡裝過TensorFlow時可能會卡住,執行前先設定環境變數USE_TF=0,PowerShell的寫法是
$env:USE_TF="0"。 - 說找不到rl_agent_config.json:這個檔案會跟著模型一起下載,不需要自己建立;載入自己電腦上的模型時,路徑要指到放模型檔的那個資料夾。
第一次執行Laya
用laya指令快速測試
安裝Laya時會一起裝好一個叫laya的指令,不用寫程式就能試。Windows直接執行虛擬環境裡的laya.exe:
.\.venv\Scripts\laya.exe "I was charged twice, please refund"
.\.venv\Scripts\laya.exe "Refactor this service" --predict
.\.venv\Scripts\laya.exe "My payment failed twice" --preset triage第一行只做語言分流,不會下載模型,幾毫秒就回來,拿來確認安裝成功。加上--predict才會真的下載模型並回答問題。--preset可以套用內建的問題組,有triage客服分流、email郵件、guard提示詞防護、moderation內容審核、router模型分流五種。什麼參數都不加,就會進入互動模式。
用Python寫客服分流程式
把下面這段存成first_laya.py,再用.\.venv\Scripts\python.exe first_laya.py執行:
from laya import Router

router = Router()  # 第一次使用時會自動下載模型

state = "Hi, we were billed twice for March. Please refund the duplicate today or we will cancel our plan."
questions = {
    "department": {"type": "choice", "instructions": "Which department should handle this?",
                   "criteria": {"billing": "invoices, payments, refunds",
                                "technical": "bugs, outages, system errors",
                                "other": "everything else"}},
    "urgency": {"type": "score", "instructions": "How urgent is this?",
                "criteria": ["not urgent", "soon", "blocking"]},
    "churn_risk": {"type": "noul", "instructions": "Does the user threaten to cancel or leave?"},
}

result = router.predict(state, questions)
print(result["answers"]["department"]["choice"])  # billing
print(result["answers"]["churn_risk"]["noul"])    # 回答「是」的機率
print(result["routing"]["model"])                 # english
questions的寫法和Jev的API相同,choice是選擇題、score是評分題、noul是是非題,department這些題目名稱由你自己取。result裡的routing會寫出這次交給哪個版本、為什麼,例如中文內容會標示成非拉丁字母,交給多語言版。
要處理長文件,就指定多語言版並把長度上限調到8,192:router.predict(long_document, questions, model="multilingual", max_len=8192)。官方測試內容在約4,000個token以內時,20次請求能答對16到18次,再長就不穩定。
把Laya架成跟Jev相容的API
laya-serve會開一個和Jev一樣是POST /v1/systemone的網址,原本寫給Jev的程式,把網址換成自己的伺服器就能接上。在PowerShell依序執行:
.\.venv\Scripts\python.exe -m pip install "laya[serve]"
$env:LAYA_DEVICE="cpu"
$env:LAYA_API_KEY="自己設定一組金鑰"
.\.venv\Scripts\laya-serve.exe
伺服器預設開在8000埠,而且對外開放,同一個網路裡的其他電腦都連得到。沒有設定LAYA_API_KEY的話完全不用驗證,任何人都能呼叫,一定要先設好金鑰再啟動。有NVIDIA顯示卡的話,把LAYA_DEVICE改成cuda。
接到Claude Desktop、Cursor這類工具
Laya也能當成MCP伺服器,支援MCP的工具例如Claude Desktop、Cursor和OpenClaw,都能直接呼叫它的laya_predict、laya_route、laya_preset、laya_status四個功能。先安裝:
pip install "laya[mcp]"再把下面這段加進工具的MCP設定檔:
{
  "mcpServers": {
    "laya": {
      "command": "laya-mcp-server",
      "env": { "LAYA_DEVICE": "cpu" }
    }
  }
}
準確度要靠微調補上
Laya官方公布的0.766準確率,是用那份決策測試自己的訓練資料微調過的laya-typed-decisions版本,同一批題目Jev是0.727。沒有微調的英文版只拿到0.362,隨便亂猜是0.318,每題都選最常見的答案也有0.461。官方的說法很直接:Laya是一個可以快速特化的底座,不適合沒經過訓練就直接拿來判斷。
官方提供一份微調筆記本,可以在Kaggle免費的兩張T4顯示卡上跑完整套流程:建立資料集、訓練、校正信心、評估,最後上傳到Hugging Face。要處理中文客服、中文審核的人,這是讓Laya堪用的主要途徑。
除了微調,也要校正信心。官方說明Laya出廠時偏向過度自信,用自己的資料替每種題型重新擬合溫度參數之後,英文版的平均校準誤差從0.466降到0.081,也就是模型說的把握和實際答對率會貼近很多。
另外兩個已知的弱點:選項超過20個的選擇題表現會明顯下滑,77類的銀行客服意圖測試只有0.425,可以把head_max_len調高到512,或拆成先分大類再分小類;英文版的是非題有時會被false和true這兩個標籤帶著走,答案一直卡在同一邊時,改成只有兩個選項的選擇題來問。
Laya AI常見問題
可以。Laya採用Apache 2.0授權,個人和公司都能免費使用、修改和商用,只要保留原本的授權聲明。
可以。Laya能在CPU上執行,官方在預先載入模型的情況下量到每次約0.19到0.46秒;有NVIDIA顯示卡時約0.03秒。
可以處理,但沒有微調前不夠準。Router會把中文交給多語言版,我們實測時它能分對部門,卻看漏了要求退款與急迫程度,正式使用前要用自己的中文資料微調並測試。
大部分可以。用laya-serve架起的伺服器接受和Jev相同的POST /v1/systemone請求,把網址換成自己的伺服器就能呼叫,但兩者的準確度與信心分數不同,門檻要重新調整。
不會。除了第一次從Hugging Face下載模型,判斷都在你自己的電腦上完成;只有線上試用頁例外,貼進去的內容會送到Hugging Face的伺服器。
本文的版本、效能數字與測試結果為2026年9月24日查核與實測的資料,Laya更新頻繁,安裝前請以GitHub與Hugging Face上的最新說明為準。