OpenAI在10月5日公布ChatGPT浮水印的做法:未來幾週內,歐盟境內所有方案的ChatGPT與Codex使用者,產出的合格文字都會被加上肉眼看不到的浮水印,技術名稱是textGrain。OpenAI在官方說明中表示,這是為了配合歐盟《人工智慧法》,法案要求生成式AI業者讓產出的文字能被機器辨識。
台灣的ChatGPT使用者暫時不受影響。OpenAI寫明這次只在歐盟上路,上線時不會把文字浮水印設成全球預設,理由是想先從實際使用與回饋中學習。開發者這邊則是全球適用:從10月5日起,各地的API客戶都能替部分模型自行開啟浮水印,預設是關閉。
textGrain的原理是在模型選詞時加進一個看不見的統計訊號,偵測器再去找這個訊號,判斷一段文字是否帶有OpenAI的浮水印。OpenAI同時公開了技術報告,並表示之後會把這項技術開源。
換掉25%字詞,偵測率剩17%
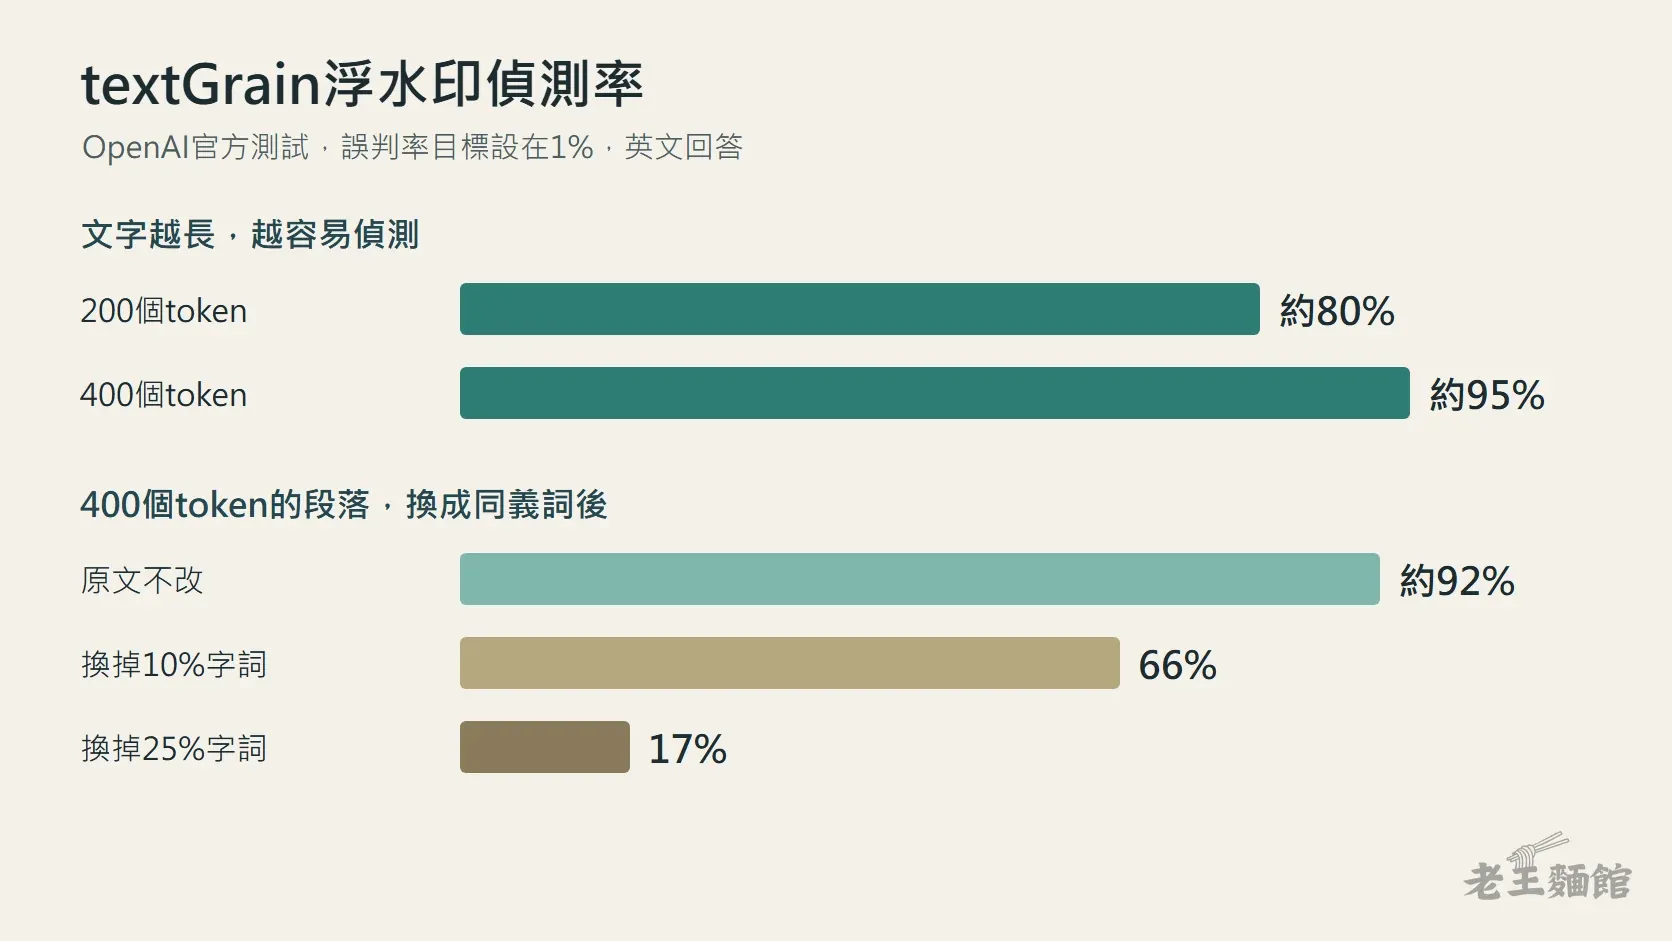
OpenAI公布的測試把誤判率目標設在1%。以心理學這類問答為例,200個token的段落約有80%能被偵測出浮水印,400個token提高到約95%。數學這類用詞選擇少的內容,偵測率明顯更低。
改寫對浮水印的殺傷力更大。同樣是400個token的英文回答,原文的偵測率約92%,把10%的字詞換成同義詞後降到66%,換掉25%只剩17%。
OpenAI表示,textGrain在內部評測中追平或勝過其他測試過的方法,包括Google DeepMind的SynthID文字版,但也承認理想條件下的好成績,不代表日常使用時能穩定偵測。
加了浮水印會不會讓回答變笨,OpenAI用最新的前沿模型Astra跑了8項基準測試,有加和沒加的分數差距都在幾個百分點以內,官方的結論是看不出有意義的差別。
| 基準測試 | Astra沒加浮水印 | Astra加浮水印 |
|---|---|---|
| Artificial Analysis Intelligence Index | 49.57分 | 49.76分 |
| GPQA Diamond | 94.44% | 93.94% |
| DeepSWE v1.1 | 72.80% | 71.68% |
| BrowseComp | 87.92% | 87.35% |
| Terminal-Bench 4.0 | 53.90% | 56.06% |
偵測器不開放給一般人
想拿一篇報告去驗是不是ChatGPT寫的,暫時做不到。OpenAI從10月5日起開放申請使用文字浮水印偵測器,但只給審核通過的研究人員與專業機構,依歐盟的AI生成內容行為準則逐案核准。OpenAI的開發者文件也寫明,文字驗證目前只開放給包括AI研究與學術機構在內的核准組織。
OpenAI說,偵測器只會回報有沒有偵測到浮水印,不會指出使用者是誰,也不會透露提示詞或對話內容。因為漏判與誤判的風險,上線時不公開給大眾使用。
沒有偵測到浮水印,不能證明是人寫的。
OpenAI列出偵測結果無法說明的事:浮水印量不出人類改了多少、無法判定著作歸屬或責任、不會識別使用者,也不能證明內容正確。文字太短、經過編輯或翻譯、來自不支援的模型、在浮水印上線前生成,或出自其他公司的AI,都可能偵測不到。
圖片與音訊的驗證工具維持公開。OpenAI已在支援的圖片加入C2PA的Content Credentials,圖片與音訊也嵌入SynthID浮水印,任何人都能到openai.com/verify上傳檔案查驗。
OpenAI表示,未來幾週會和雲端合作夥伴合作,讓透過雲端平台使用OpenAI模型的客戶也能開啟文字浮水印,技術報告也會在同一段時間補上更多細節。