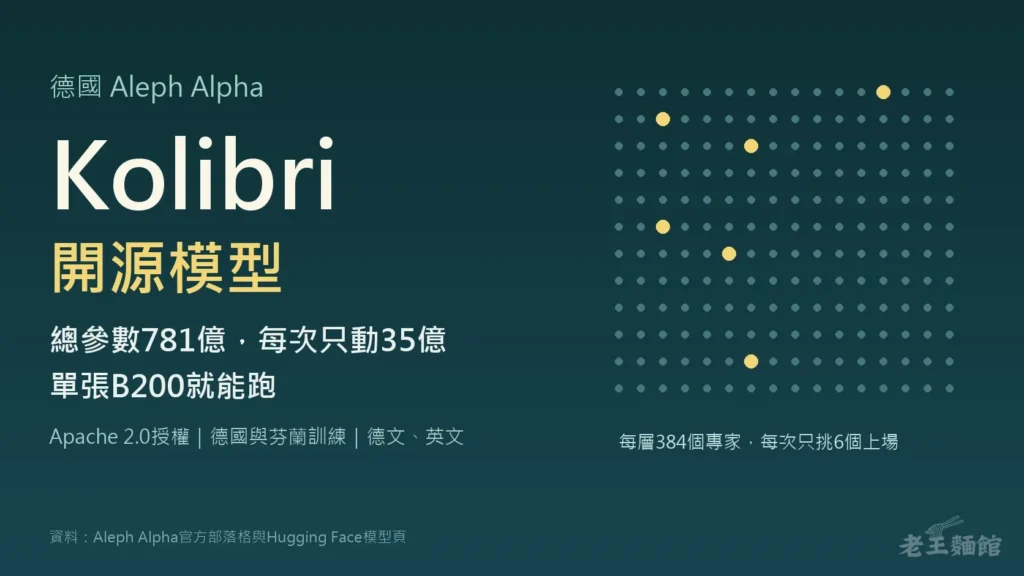
德國人工智慧(AI)公司Aleph Alpha在10月3日開源大型語言模型Kolibri,總參數781億,每次運算只啟用約35億,以Apache 2.0授權放上Hugging Face,任何人都能下載、修改、商用。官方強調Kolibri從開發到訓練都在德國與芬蘭完成,稱它是「主權」開放權重模型。
Kolibri採混合專家架構,50層、每層有384個專家加1個共用專家,每次只挑6個上場,所以總參數大、實際運算量小。權重用FP8格式存放,約78GB,模型頁列出的最低硬體是1張輝達B200或H200,或2張H100、A100 80GB。
Aleph Alpha在官方部落格解釋「主權」的意思:
我們的團隊在德國打造這個模型,在德國與芬蘭的基礎設施上訓練,受歐洲與德國法律規範,沒有外國控制。
自家跑分英文、德文綜合都贏GPT-OSS 120B
Aleph Alpha公布的評測裡,Kolibri開到高推理強度,英文綜合分75.5、德文綜合分70.8,兩項都高於OpenAI的GPT-OSS 120B、輝達的Nemotron 3 Super 120B、法國Mistral的Mistral Small 4 119B,以及阿里巴巴的Qwen3.6-35B-A3B。分數是Aleph Alpha用同一套設定自行測得。
| 模型 | 英文綜合 | 德文綜合 | GPQA Diamond | AIME 2025 |
|---|---|---|---|---|
| Kolibri | 75.5 | 70.8 | 84.3 | 96.9 |
| Nemotron 3 Super 120B | 73.0 | 67.9 | 78.0 | 91.7 |
| GPT-OSS 120B | 72.3 | 70.2 | 76.4 | 90.6 |
| Qwen3.6-35B-A3B | 71.4 | 67.3 | 83.4 | 84.6 |
| Mistral Small 4 119B | 63.1 | 61.4 | 74.7 | 79.8 |
| Kolibri Origin | 54.1 | 46.4 | 68.1 | 81.9 |
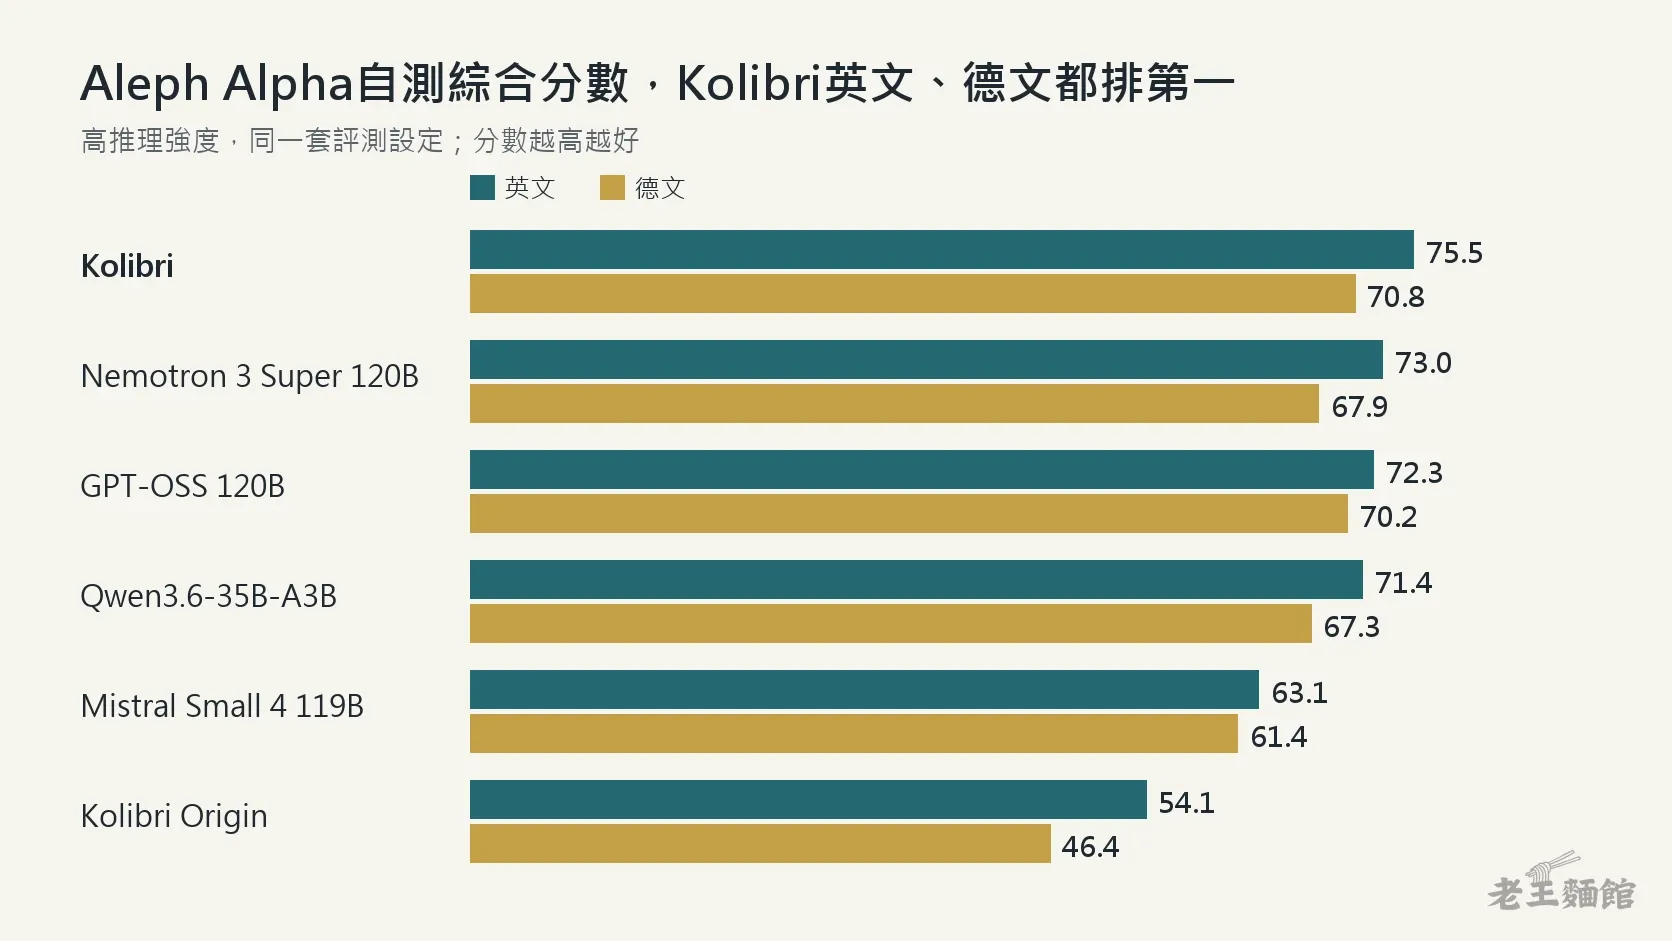
單項成績上,Kolibri在數學競賽題AIME 2025拿96.9分,程式測驗HumanEval+拿92.7分,研究所程度科學問答GPQA Diamond拿84.3分。比較基準裡的Kolibri Origin是上一代內部模型,總參數306億,沒有對外公開。
768張B200訓練21天,官方語言只有德文和英文
模型頁寫明,Kolibri預訓練用了20兆個token,在768張輝達B200上跑了21天,之後再加3.44兆token的中期訓練與2,010億token的長文訓練。官方估算整個訓練耗電約950MWh,也就是約95萬度電。
Kolibri原生一次可讀入262,144個token,官方用外推方式驗證到1,048,576個token。模型支援推理模式,分低、中、高三段強度,也支援工具呼叫,知識截止日是2026年6月18日。
模型頁列出的語言只有德文與英文,沒有列中文。下載後可以用Aleph Alpha自家的推理套件或vLLM架設,Hugging Face上分成FP8的Kolibri-1,以及原始精度的Kolibri-1-BF16兩個版本,企業部署與客製化要另外找Aleph Alpha業務洽談。